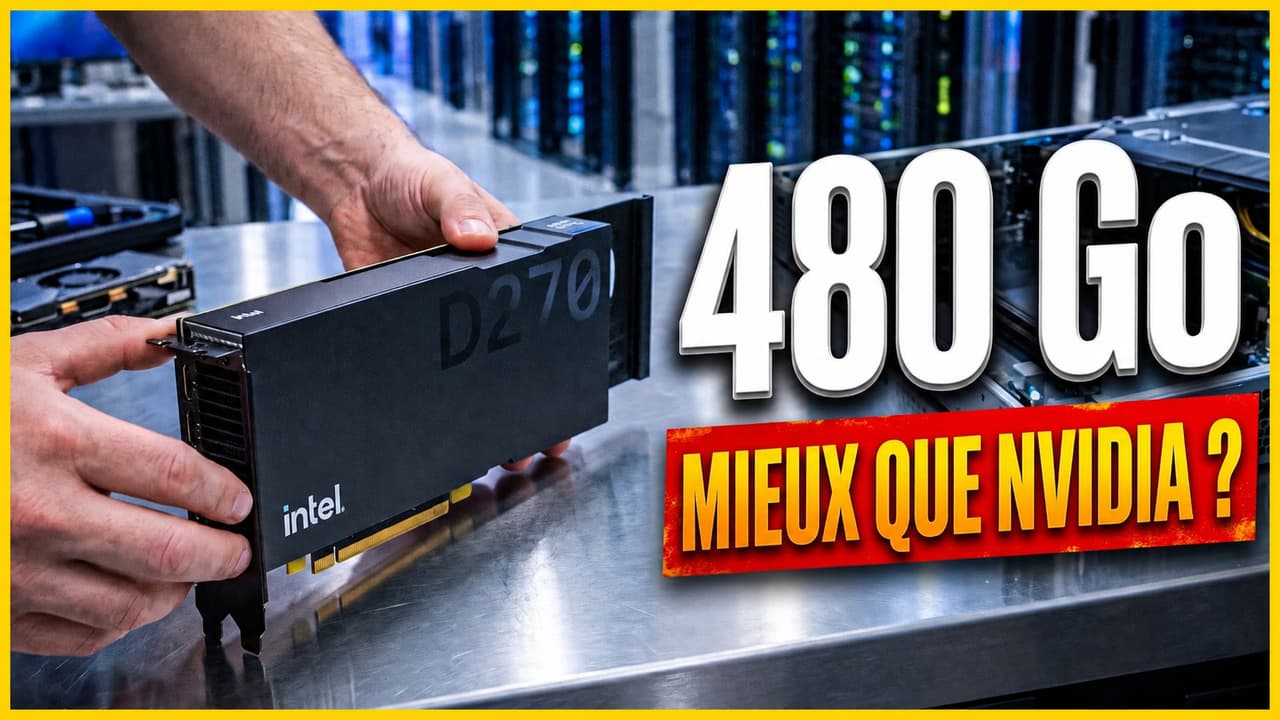
title: "Intel GPU D270 (Crescent Island) : 480 Go de mémoire et jusqu'à 5,9x plus rapide que NVIDIA ?" description: "Découvrez l'Intel GPU D270 (Crescent Island), la carte graphique serveur PCIe refroidie par air de 350W qui embarque jusqu'à 480 Go de LPDDR5X et défie la NVIDIA RTX PRO 6000 Blackwell en IA et HPC." date: 2026-11-19 author: "Makertronic" site: "makertronic-yt.com" tags: ["Intel", "NVIDIA", "GPU D270", "Crescent Island", "Hardware", "IA", "HPC", "Datacenter"]
Intel GPU D270 (Crescent Island) : 480 Go de mémoire sur une seule carte PCIe pour défier NVIDIA
480 gigaoctets de mémoire sur une seule carte graphique. Refroidie par air. Dans un simple port PCIe 5.0. Non, il ne s'agit pas d'un prototype expérimental, et surtout, cette carte n'est pas signée NVIDIA.
Alors que beaucoup pensaient Intel définitivement distancé sur le marché des accélérateurs haute performance, le fondeur vient de créer la surprise avec l'Intel GPU D270 (nom de code Crescent Island). Dévoilée dans le cadre de l'OCP Global Summit 2026 et mise en avant à Supercomputing '26, cette carte de 350 watts s'attaque directement à la NVIDIA RTX PRO 6000 Blackwell Server Edition (600 watts) sur le terrain de l'inférence IA et du calcul haute performance (HPC).
Regarder la vidéo complète sur YouTube : [Insérer ici le lecteur intégré de votre vidéo YouTube]
Une fiche technique qui prend le marché à contre-pied
Plutôt que de copier les accélérateurs hors de prix nécessitant des infrastructures à refroidissement liquide sur mesure, Intel a choisi une approche pragmatique : maximiser la capacité mémoire et l'efficacité énergétique dans un format serveur standard.
Sous le capot, la GPU D270 repose sur la nouvelle architecture Intel Xe 3P :
- Calcul : 32 cœurs Xe et 256 moteurs matriciels XMX.
- Puissance brute IA : 1,3 pétaflops en FP8.
- Format et consommation : carte PCIe 5.0 refroidie par air avec un TDP de seulement 350 W, compatible avec n'importe quel serveur d'entreprise classique.
- Mémoire LPDDR5X : au lieu de se limiter à de la mémoire HBM très coûteuse et complexe à produire, Intel utilise de la LPDDR5X. Le modèle de référence signé Intel embarque 160 Go de mémoire (pour une bande passante de 1,5 To/s), tandis que la conception ouverte permet aux partenaires OEM et ODM de proposer des configurations grimpant jusqu'à 480 Go sur une seule carte.
Concrètement, cette capacité mémoire hors norme permet de faire tourner un modèle d'IA de 300 milliards de paramètres sur une unique carte graphique. En assemblant huit cartes dans un seul serveur standard, on dépasse la barre du mille milliards de paramètres (1 trillion), sans refroidissement exotique.
L'arme secrète : le support natif du FP64 face à NVIDIA
La plupart des GPU dédiés à l'inférence IA sacrifient la précision mathématique pour privilégier les formats légers (FP4, FP8). Si cela suffit pour générer du texte, c'est inutilisable pour la simulation scientifique, la finance quantitative ou l'exploration sismique, qui exigent une double précision (FP64).
L'Intel GPU D270 joue sur les deux tableaux en prenant en charge nativement tous les formats, du FP4 jusqu'au FP64 plein débit (avec 64 opérations FP64 FMA par cœur).
Sur du silicium de pré-production, Intel a publié une première série de benchmarks comparant sa D270 (350 W) à la NVIDIA RTX PRO 6000 Blackwell Server Edition (600 W) :
| Charge de travail / Benchmark | Domaine | Avantage Intel GPU D270 (350 W) vs NVIDIA RTX PRO 6000 Blackwell (600 W) |
|---|---|---|
| Monte Carlo européenne | Modélisation financière (HPC) | 5,9x plus de débit |
| Black-Scholes | Modélisation financière (HPC) | 5,6x plus rapide |
| Binomial | Modélisation financière (HPC) | 4,6x plus rapide |
| Drex 2.0 | IA décisionnelle | -29 % de latence |
| Qwen 3 30B-A3B | Inférence LLM | 1,12x plus de débit |
Note : ces mesures provenant d'Intel sur du matériel de pré-production (l'échantillonnage client étant en cours), il conviendra bien sûr d'attendre les tests indépendants sur les versions commerciales finales. Néanmoins, avec 250 W de consommation en moins, le ratio performance par watt annoncé est particulièrement impressionnant.
L'inférence désagrégée : penser l'infrastructure pour l'IA agentique
Avec l'essor des agents IA autonomes — capables de lire d'immenses contextes, d'appeler des outils et de lancer des simulations en temps réel — demander à une seule puce de tout gérer crée un goulot d'étranglement.
La stratégie dévoilée par Intel repose sur l'inférence désagrégée, en répartissant chaque tâche sur le matériel le plus adapté au sein de racks standards refroidis par air :
- Intel GPU D270 (Prefill) : grâce à sa capacité mémoire massive, elle absorbe les prompts géants et les contextes lourds.
- SambaNova SN50 RDU (Decode) : des puces spécialisées prennent le relais pour générer les tokens à très haute vitesse.
- Intel Xeon 6 et Xeon 6+ (Orchestration) : les processeurs gèrent les outils, la logique système et les transferts de données, avec des configurations pouvant dépasser 46 000 cœurs par rack.
Peut-on vraiment briser le verrou logiciel de CUDA ?
C'est la question centrale face à NVIDIA : le matériel ne vaut rien sans l'écosystème logiciel. Intel mise ici sur une pile 100 % ouverte, articulée autour de SYCL, vLLM et d'un support « Jour 0 » des nouveaux modèles ouverts (comme Muse Glimmer de Meta).
Pour prouver que la migration hors de CUDA est réaliste, Intel s'appuie sur un cas concret d'imagerie sismique réalisé avec l'entreprise Viridien :
- Le portage du code existant (initialement écrit pour CUDA/HIP) vers la D270 via SYCL a pris moins d'un mois, sans modifier le code côté CPU.
- 90 % des noyaux de calcul ont fonctionné correctement sans aucune optimisation spécifique à Intel.
- Le système a atteint jusqu'à 70 % de la performance théorique maximale dès ce premier essai.
Conclusion : un vrai tournant pour les datacenters ?
Avec la GPU D270, Intel ne cherche pas à affronter NVIDIA sur les clusters d'entraînement monumentaux à plusieurs dizaines de milliers d'euros. Le constructeur vise le nerf de la guerre actuel : l'inférence à grande échelle et le calcul scientifique accessible, avec une mémoire gigantesque, une enveloppe thermique maîtrisée et une installation sans contrainte dans les serveurs existants.
Il reste désormais à découvrir les tarifs finaux et les benchmarks indépendants lors de la disponibilité commerciale.
Et vous, qu'en pensez-vous ? Cette approche à 480 Go de LPDDR5X refroidie par air peut-elle sérieusement menacer la domination de NVIDIA en datacenter, ou CUDA restera-t-il indétrônable ? Partagez votre avis en commentaire !
Sources officielles
- Intel Newsroom — The Case For Intel GPU D270 in High-Performance Computing
- Intel Newsroom — Intel Accelerates Open Infrastructure for the Agentic AI Era (OCP 2026)