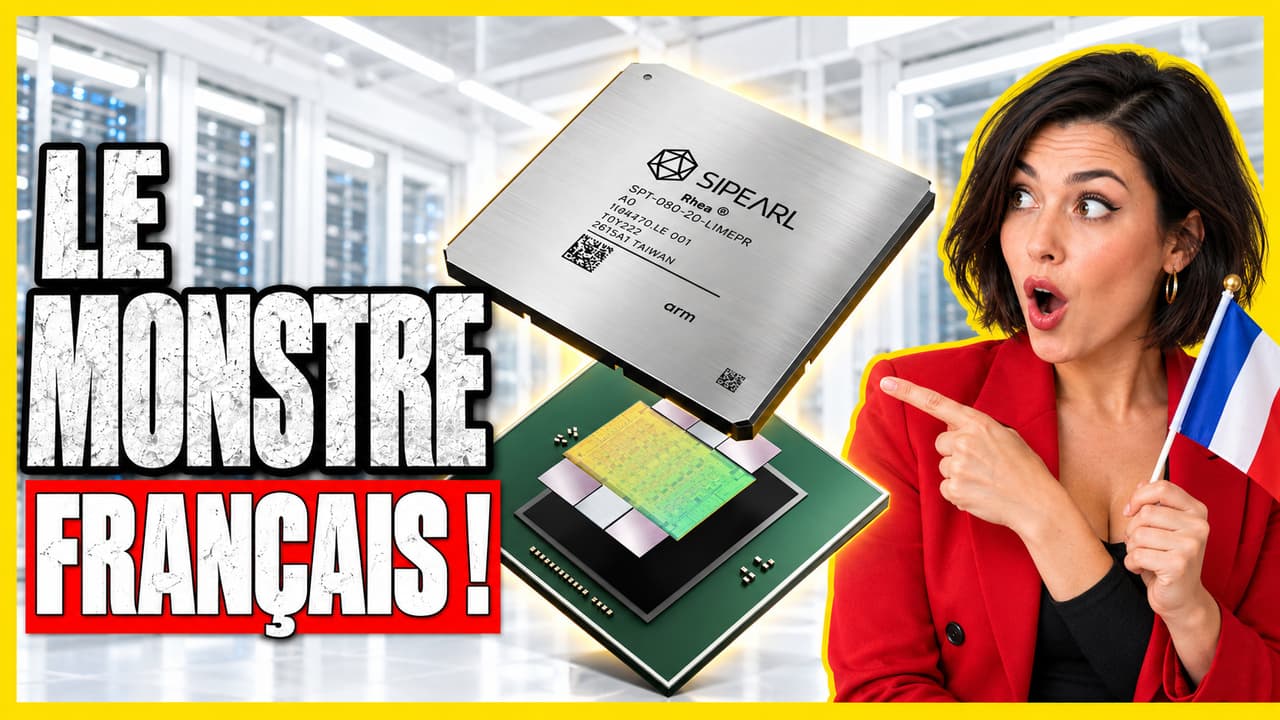
SiPearl Rhea1 : le CPU français à 80 cœurs et 64 Gio de HBM qui arrive dans JUPITER
61 milliards de transistors. 80 cœurs. 64 Gio de mémoire HBM2e intégrée au boîtier. Ce n’est pas la fiche technique d’un GPU : c’est celle de Rhea1, le processeur conçu par la société française SiPearl pour le calcul haute performance et certaines charges d’intelligence artificielle.
Le plus étonnant n’est peut-être pas son nombre de cœurs. C’est la façon dont SiPearl a construit le processeur autour d’un problème que connaissent bien les utilisateurs de PC et de GPU : avoir de la puissance de calcul ne sert pas à grand-chose si les données n’arrivent pas assez vite. Voilà pourquoi la mémoire HBM est au centre de l’histoire.
En septembre 2026, les premiers Rhea1 ont été livrés à Bull pour leur intégration dans des serveurs destinés au supercalculateur JUPITER. Un premier serveur de référence équipé de la puce a également été livré à HPE à Grenoble dans le cadre du projet OpenCUBE. L’heure est donc venue de regarder ce que cette machine promet réellement.
Rhea1, c’est quoi exactement ?
Rhea1 est un CPU pour serveurs et supercalculateurs, conçu par SiPearl, entreprise française issue de l’écosystème de l’European Processor Initiative. Il n’a pas vocation à remplacer un Ryzen dans votre PC : il vise les simulations scientifiques, le calcul intensif, les traitements de données et certains usages d’IA.
Le qualificatif « français » concerne la conception de la puce et l’entreprise qui la développe. SiPearl est une société fabless : elle conçoit ses processeurs mais ne possède pas l’usine qui grave le silicium. Rhea1 est fabriqué par TSMC. C’est une distinction importante quand on parle de souveraineté technologique.
| Élément | Caractéristique annoncée |
|---|---|
| Processeur | SiPearl Rhea1, architecture Arm v8.4-A |
| Cœurs | 80 Arm Neoverse V1 |
| Calcul vectoriel | Deux unités SVE de 256 bits par cœur |
| Cache L2 | 1 Mio par cœur |
| Cache partagé | 80 Mio de cache système distribué |
| Mémoire dans le boîtier | Quatre piles HBM2e, 64 Gio au total |
| Mémoire externe | Quatre interfaces DDR5 |
| Complexité | Environ 61 milliards de transistors |
La nuance entre 64 Go dans un titre grand public et 64 Gio dans la fiche technique mérite d’être signalée : 64 Gio désigne une capacité exprimée en puissances de deux. C’est la valeur indiquée dans la documentation technique de SiPearl.
80 cœurs Neoverse V1 : pourquoi ce choix ?
Neoverse est la famille de cœurs Arm destinée aux infrastructures. Le V1 vise notamment les tâches de calcul exigeantes. Chaque cœur de Rhea1 peut exécuter du code Arm classique, mais dispose aussi de deux unités vectorielles SVE de 256 bits.
Une opération vectorielle permet de traiter plusieurs nombres avec une même instruction. Sur des calculs répétés à très grande échelle — simulation de fluides, calcul scientifique, analyse de matrices — ce mécanisme peut être décisif. Avec un vecteur de 256 bits, on peut par exemple représenter quatre nombres de 64 bits dans un même vecteur. Cela ne veut pas dire que tous les programmes deviennent automatiquement quatre fois plus rapides : il faut que le calcul s’y prête, que le code soit vectorisé et que la mémoire puisse alimenter les unités de calcul.
SiPearl annonce également 1 Mio de cache L2 par cœur et 80 Mio de cache système distribué. Ces mémoires rapides évitent certains allers-retours vers la RAM. Sur un processeur à 80 cœurs, leur organisation et les échanges entre cœurs comptent autant que leur capacité brute.
Ces cœurs ne sont-ils pas déjà anciens ?
La question est légitime : Arm a présenté Neoverse V1 il y a plusieurs années. Rhea1 ne mise donc pas sur le cœur Arm le plus récent. Sa proposition repose sur l’ensemble : 80 cœurs, calcul vectoriel, caches, mémoire HBM2e et intégration dans un système HPC.
Un cœur récent peut dominer en performance par thread, alors qu’un processeur doté d’une mémoire mieux adaptée peut se montrer intéressant sur un calcul limité par les transferts de données. Impossible de départager ces situations à partir des seules fiches techniques. Il faudra mesurer les applications visées, le débit mémoire, la consommation et le comportement sur des tâches parallèles.
La vraie particularité : 64 Gio de HBM2e sur un CPU
Dans un PC, le CPU accède généralement à des barrettes de DDR placées sur la carte mère. Rhea1 ajoute quatre piles de HBM2e intégrées dans son boîtier, pour une capacité totale annoncée de 64 Gio, tout en conservant des interfaces DDR5 pour disposer d’une mémoire système plus étendue.
Imaginez 80 personnes capables de traiter chacune beaucoup de dossiers. Si les dossiers arrivent par un couloir trop étroit, augmenter le nombre de personnes ne règle pas le problème. La HBM, ou High Bandwidth Memory, vise justement à élargir ce couloir : sa conception permet de transférer beaucoup de données en parallèle, à proximité du processeur.
Cette architecture est particulièrement intéressante pour les applications limitées par la bande passante mémoire. En revanche, « HBM » ne signifie pas « plus rapide partout » : la capacité, la latence, l’emplacement des données et la façon dont le logiciel exploite les différents types de mémoire changent le résultat. Si un jeu de données déborde de la HBM et s’appuie surtout sur la DDR5, le comportement sera différent. SiPearl ne publie pas dans sa fiche une mesure universelle qui permettrait de prédire le gain pour chaque application.
Pour donner une idée de l’échelle : 64 Gio de HBM représentent plus de deux fois les 24 Gio de VRAM d’une RTX 3090. Mais il s’agit ici de mémoire attachée à un CPU, avec d’autres usages et une autre architecture ; cette comparaison illustre une capacité, pas une équivalence de performances avec un GPU.
Quel rôle dans JUPITER ?
JUPITER est le supercalculateur installé au centre de recherche de Jülich, en Allemagne. Il comprend notamment un Booster fortement accéléré par des GPU et un Cluster destiné à d’autres types de charges.
La documentation officielle de Jülich prévoit pour le Cluster 162 nœuds équipés chacun de deux Rhea1, aux côtés de nœuds AMD. Cela représente 324 processeurs Rhea1 et 25 920 cœurs Arm si cette configuration prévue est installée telle quelle. Les nœuds SiPearl y sont encore indiqués comme devant être installés ultérieurement : il s’agit d’une configuration annoncée, pas d’un parc dont nous pouvons déjà publier des résultats de production.
Il faut aussi éviter une confusion : la performance exascale de JUPITER ne repose pas sur Rhea1 seul. Le Booster utilise des systèmes NVIDIA GH200 Grace Hopper. Rhea1 doit rejoindre le Cluster, une autre partie de cette infrastructure. Cette précision n’enlève rien à l’intérêt du processeur : intégrer un CPU conçu en Europe dans une telle machine est déjà une étape industrielle majeure.
Des puces livrées, mais quels benchmarks ?
La livraison des premières puces à Bull marque le passage de la fiche produit à l’intégration matérielle dans les serveurs BullSequana XH3000. De son côté, le serveur Seine livré à HPE Grenoble doit servir aux travaux du projet OpenCUBE. Ces étapes permettent de valider le matériel, d’adapter les logiciels et de préparer des mesures sur des machines réelles.
Ce que nous attendons maintenant, ce sont des benchmarks publics et reproductibles de Rhea1. Un simple chiffre de performance maximale ne suffira pas. Pour comprendre l’intérêt de cette architecture, il faudra regarder :
- La bande passante mémoire mesurée et son évolution quand les 80 cœurs travaillent ensemble ;
- Les performances par cœur et par socket, notamment sur du code vectorisé SVE ;
- Les applications HPC réelles, avec des jeux de données assez grands pour solliciter la HBM et la DDR5 ;
- La consommation électrique et les performances par watt ;
- La comparaison à configuration comparable avec d’autres CPU de serveurs, en précisant les compilateurs et les réglages utilisés.
On peut trouver des mesures de Neoverse V1 dans d’autres machines, comme certains serveurs utilisant AWS Graviton3. Elles éclairent les capacités du cœur, mais ne constituent pas des benchmarks de Rhea1 : le nombre de cœurs, les fréquences, les caches et surtout la mémoire diffèrent.
Ce que représente vraiment ce processeur français
Rhea1 a de quoi impressionner : 80 cœurs Arm, 61 milliards de transistors et 64 Gio de HBM2e sur un CPU, le tout destiné à rejoindre un supercalculateur européen. Son intérêt technique tient à un pari clair : associer beaucoup de calcul parallèle à une mémoire capable de suivre le rythme.
La prochaine étape sera la plus parlante pour les passionnés de hardware : voir comment cette architecture se comporte dans des serveurs opérationnels et sur des charges de travail concrètes. C’est là que nous saurons si le « monstre français » impressionne aussi dans les résultats.
Et vous : sur Rhea1, vous surveillerez d’abord les performances par cœur, la bande passante HBM ou l’efficacité énergétique ?
Sources
- SiPearl — fiche technique officielle de Rhea1
- SiPearl — présentation de Rhea1
- SiPearl et Bull — livraison des premiers Rhea1 pour JUPITER, septembre 2026
- SiPearl — livraison d’un serveur Seine à HPE pour OpenCUBE, septembre 2026
- Centre de recherche de Jülich — configuration officielle de JUPITER
- Arm — architecture Neoverse V1 et unités SVE